
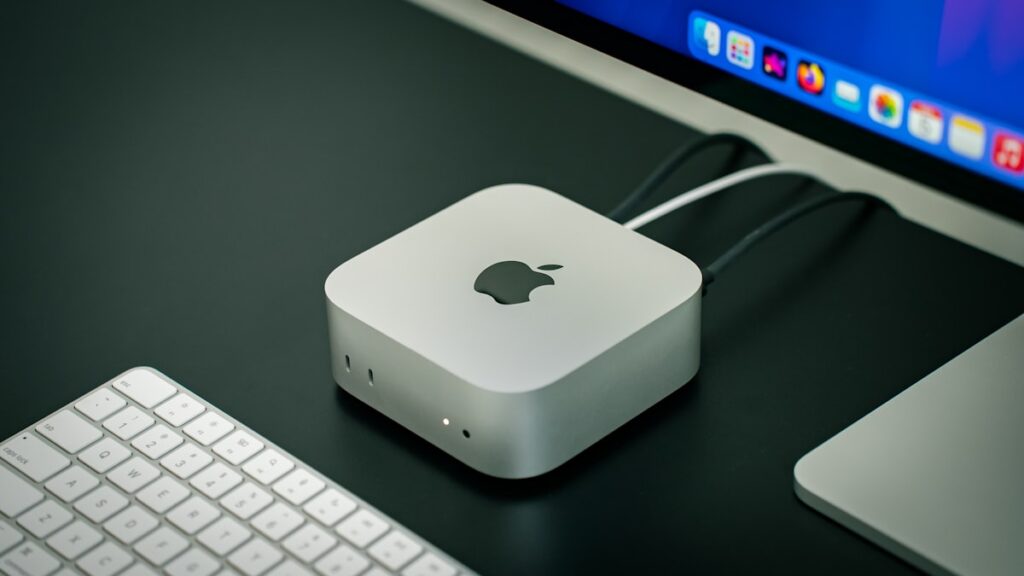

新しいM6チップで、AppleはローカルAIの計算の前部および中心を置く。 しかし、M6 Mac – 特に新しいMacミニ – 実際に自分のマシン上で直接大きな言語モデル(LLM)を実行しているのですか? マーケティングメッセージではなく、2つの数字に答えが現れます。
関連項目: AppleはM6チップで新しいMac miniを発表 – ここでは、ローカルLMの手段を破壊します。
なぜLMをMac上でローカルで実行するのですか?
ローカルの実行言語モデルには3つの具体的な利点があります:あなたのデータは機械(プライバシー)を去りません、 per-request APIの費用はなく、完全にオフラインで動作します。 機密文書、コーディングヘルプ、または単に実験のために、それは魅力的です – ハードウェアが追いつくことを提供します。 そして、これはマーケティングメッセージが練習で方法を分けます。
2つの数字はそれを決めます – 神経エンジンではありません
LLM の練習のために、ほとんどの 2 つのメートルの問題:
- ユニファイドメモリ(RAM): それが決定する とりあえず モデルは、すべてのメモリに収まります。 モデルがいっぱいにロードされなければならない – RAMに収まらないと、SSDを介して実行またはクロールしません。
- 記憶帯域幅(GB/s): それが決定する どのように高速 テキストは生成されます。 LLMインフェレンスは、ほぼ常に帯域幅制限されています。すべてのトークンでは、モデル全体がメモリを一度読み込む必要があります。
速度の天井のための親指の有用な規則: トークン/秒 ≈ メモリの帯域幅 ÷ RAM のモデルサイズ. 現実では、KVキャッシュ、注意、およびカーネルのオーバーヘッドが追加の帯域幅を消費するので、約60〜80パーセントに達します。
M6 Macミニが実際に提供しているもの
新しいMac miniは、153 GB /秒の帯域幅($ 899)で統一メモリの16 GBから始まります。 24GBまたは32GBにアップグレードすると、帯域幅を170GB/秒に引き上げます。 ふりがな 最大32 GB – それはローカルLMの決定的な限界です。
- 16 GB (153 GB/s): macOS以降、約10〜12 GBは使用可能です。 現実主義は7B/8Bモデル(4ビットの量子化、~5 GB)です–チャット、要約、および簡単なコーディングの助けのための理想。
- 24 GB (170 GB/s): 現在14Bモデル(~8–9 GB)は、長い文脈のためのヘッドルームと快適にフィットします。
- 32 GB (170 GB/s): 天井。 これは30B / 32Bモデル(4ビット〜18〜20 GB)を読み込みます。 70Bクラス(~40 GB)のモデルは適合しません。
どのように高速ですか? いくつかの参照ポイント
M6 の 170 GB/s (現実的な 70 パーセントの割引と) に適用され、大まかに取得します。
- 8Bモデル (〜5 GB):約20〜25トークン/秒 – 読書速度よりも速く、非常に快適に。
- 14Bモデル (〜8.5 GB):約12〜16トークン/秒 – より深刻なタスクのために使用可能です。
- 32Bモデル (〜19 GB):約5〜7トークン/秒 – 著しく遅くなりますが、すべての単語を待っていない場合は、品質応答のために罰金が科されます。
コンテキスト: 153-170 GB/s のベース M6 は固く、帯域幅のモンスターではありません。 M-MaxまたはUltraチップを搭載したMac Studioは、400〜800 GB /秒、最大192 GBのRAMに達する – 70Bモデルと高速化が可能である。
デュアルニューラルエンジンはLMSに役立ちますか?
アップルは、新しいデュアルニューラルエンジン(16コアユニット)でM6を販売しています。 重要: Ollama、LM Studio、または llama.cpp などの一般的な LLM ツールは、ほぼ独占的に計算します。 GPUの特長ネラルエンジン(ANE)ではなく。 ANEは主にApple独自のデバイス機能とCoreMLモデルを加速します。 そのため、古典的なローカルチャットボットでは、2番目のニューラルエンジンは、名前の提案よりも少なくなります。ボトルネックはメモリ帯域幅を維持します。
適切なソフトウェア
- オラマ – 最も簡単なエントリ:1つのコマンド、モデルの読み込みと実行。 最初のテストに最適です。
- LMスタジオ – モデルブラウザでグラフィカルなインターフェイス、端末なしで初心者に最適です。
- メニュー – Appleの独自のフレームワーク、特にAppleのシリコンのために最適化され、一般的なランタイムよりもはるかに高速です。
- ラマ.cpp – 細い基礎多くの用具は造ります;高度のユーザーのための最高の制御。
Mac mini、Studio、Pro – ローカルLMにどのような適合がありますか?
要する: M6 Mac miniは理想的なエントリポイントです ローカル LLM は 14B まで、32 GB の variant は ~32B までです。 70Bモデル、並行して複数のモデルをロードするか、または高速化を望む人は誰でも定期的に作業できます。 Macスタジオ M-MaxまたはUltraチップ(遠くのRAMと帯域幅) 「Mac Pro with M6」はありません。トップモデルはまだUltraチップに依存しています。 家と開発者のセットアップの大部分は、しかし、32 GBのMac miniは価格パフォーマンスの甘いスポットです。
よくある質問(FAQ)
ローカルLLMで16 GBは十分ですか? 7B / 8Bモデルの場合、はい – 彼らはチャット、要約、および単純なコーディングタスクをうまくカバーします。 14B 以上の場合は、24 または 32 GB の variant を選択します。
どのモデルは良いスタートですか? 現在の8Bモデル(Llama、Qwen、またはgpt-ossファミリーなど)は、M6 Mac miniで滑らかに実行され、驚くべき結果が得られます。
「4ビット定量」とはどういう意味ですか? メモリ使用量が約4分の圧縮で、品質が小さくなります。 消費者のハードウェアでモデルを使用可能にする標準的な方法です。
Mac miniで70Bモデルを実行できますか? 実際にはいいえ – 彼らは約40 GB以上を必要とし、32 GBでMacミニトップス。 これは、より統一されたメモリでMac Studioを呼び出します。
Mac miniまたはグラフィックカードでゲームPCが良いですか? VRAMの多くを備えた専用のGPUは、帯域幅が速くなりますが、高価で力強いです。 Macミニは、非常に低い電力の描画、静かな操作、統一されたメモリのおかげで、すべての大きなモデルをロードする能力で得点します。
ソース: 9to5マック, アップルインサイダー, アップルニュースルーム. 速度の図は親指の帯域幅規則に基づいて近似であり、モデル、量子化、および文脈の長さによって変わります。

















