
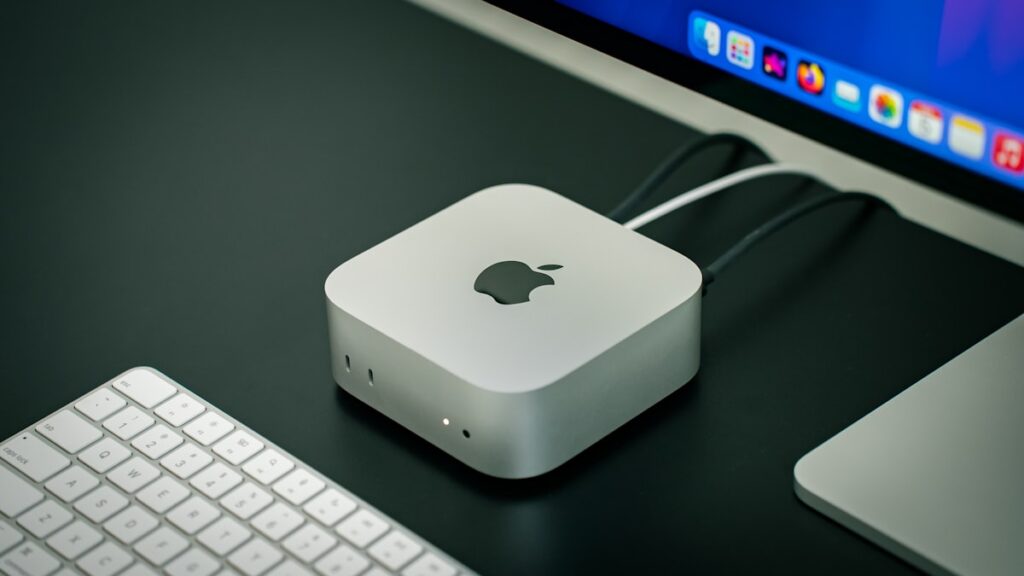

Con il nuovo chip M6, Apple mette l’intelligenza artificiale locale davanti e centro. Ma quanto bene fa il M6 Mac – in particolare il nuovo Mac mini – in realtà gestire in esecuzione grandi modelli di lingua (LLMs) direttamente sulla vostra macchina? La risposta arriva a due numeri, non il messaggio di marketing.
Correlati: Apple presenta il nuovo Mac mini con chip M6 – qui si rompe ciò che significa per LLM locali.
Perché eseguire LLMs localmente su un Mac affatto?
Un modello di lingua in esecuzione locale ha tre vantaggi concreti: i dati non lasciano mai la macchina (privacy), non ci sono costi API per-richiesta, e funziona completamente offline. Per i documenti sensibili, l’aiuto di codifica, o semplicemente sperimentando, che è attraente – a condizione che l’hardware si alzi. E questo è esattamente dove il messaggio di marketing si separa con la pratica.
Due numeri lo decidono – non il motore neurale
Per la pratica LLM, due metriche più importanti:
- Memoria unificata (RAM): determina che i modelli si adattano alla memoria. Un modello deve essere caricato in pieno – se non si adatta a RAM, o non verrà eseguito o striscia via SSD.
- Larghezza di banda di memoria (GB/s): determina quanto velocemente il testo viene generato. L’inferenza LLM è quasi sempre limitata alla larghezza di banda: per ogni singolo token, l’intero modello deve essere letto attraverso la memoria una volta.
Una regola utile del pollice per il soffitto di velocità: token/secondo ≈ larghezza di banda di memoria ÷ formato modello in RAM. In realtà si raggiunge circa il 60–80 per cento di questo, perché la cache KV, l’attenzione e overhead del kernel consumano larghezza di banda aggiuntiva.
Cosa offre M6 Mac mini
Il nuovo Mac mini inizia a 16 GB di memoria unificata con 153 GB/s di larghezza di banda ($899). L’aggiornamento a 24 o 32 GB aumenta la larghezza di banda a 170 GB/s. The massimo 32 GB – e questo è il limite decisivo per le LLM locali.
- 16 GB (153 GB/s): dopo macOS, circa 10–12 GB rimangono utilizzabili. Realistici sono modelli 7B/8B (4 bit quantizzati, ~5 GB) – ideale per chat, sintesi e semplice aiuto di codifica.
- 24 GB (170 GB/s): ora 14B modelli (~8–9 GB) si adattano comodamente, con headroom per un contesto più lungo.
- 32 GB (170 GB/s): il soffitto. Questo carica anche modelli 30B/32B (4-bit, ~18–20 GB) – stretto, ma fattibile. I modelli della classe 70B (~40 GB) non si adattano più.
Quanto è veloce? Alcuni punti di riferimento
Applicato alla M6 170 GB/s (con uno sconto realistico del 70 per cento), si ottiene approssimativamente:
- Modello 8B (~5 GB): circa 20–25 token/s – più veloce della velocità di lettura, molto confortevole.
- 14B modello (~8.5 GB): circa 12–16 token/s – utilizzabile per compiti più gravi.
- Modello 32B (~19 GB): circa 5–7 token/s – notevolmente più lento, ma bene per le risposte di qualità se non si aspetta ogni parola.
Per contesto: la base M6 a 153–170 GB/s è un mostro solido ma senza larghezza di banda. Un Mac Studio con un chip M-Max o Ultra raggiunge i 400 a oltre 800 GB/s e fino a 192 GB di RAM, dove i modelli 70B e le velocità più elevate diventano possibili.
Il doppio motore neurale aiuta con LLM?
Apple commercializza la M6 con un nuovo doppio motore neurale (due unità 16 core). Importante da sapere: gli strumenti LLM comuni come Ollama, LM Studio, o llama.cpp computo quasi esclusivamente sulla GPU, non sul motore neurale (ANE). L’ANE accelera principalmente le caratteristiche on-device di Apple e i modelli CoreML. Così per i classici chatbot locali, il secondo Neural Engine porta meno del nome suggerisce – il collo di bottiglia rimane larghezza di banda di memoria.
Il software giusto
- Ollama – la voce più semplice: un comando, il modello carica e corre. Ideale per un primo test.
- LM Studio – un’interfaccia grafica con un browser modello, grande per i principianti senza un terminale.
- MLX – Quadro di Apple, ottimizzato specificamente per Apple Silicon e spesso un po ‘più veloce dei runtime generici.
- Llama.cpp – la fondazione magra molti strumenti si accumulano; il massimo controllo per gli utenti avanzati.
Mac mini, Studio o Pro – cosa si adatta per LLM locali?
In breve: il M6 Mac mini è il punto di ingresso ideale per LLM locali fino a circa 14B, e con la variante 32 GB fino a ~32B. Chiunque lavori regolarmente con modelli 70B, caricando diversi modelli in parallelo, o desiderando velocità elevate dovrebbe raggiungere per il Mac Studio con un chip M-Max o Ultra (molto più RAM e larghezza di banda). Non c’è “Mac Pro con M6” – i primi modelli si affidano ancora ai chip Ultra. Per la maggior parte delle impostazioni casa e sviluppatore, però, il Mac mini con 32 GB è il punto dolce prezzo-performance.
Domande frequenti (FAQ)
È sufficiente 16 GB per le LLM locali? Per modelli 7B/8B, sì – coprono chat, riassunti e semplici attività di codifica bene. Per 14B e più grande, scegliere la variante 24 o 32 GB.
Quale modello è un buon inizio? Un attuale modello 8B (ad esempio dalla famiglia Llama, Qwen o gpt-oss) in una quantizzazione a 4 bit funziona senza problemi su qualsiasi mini M6 Mac e offre già risultati sorprendentemente buoni.
Cosa significa “quantificato a 4 bit”? Una compressione che approssimativamente trimestre l’utilizzo della memoria con solo una piccola perdita di qualità. È il modo standard per rendere i modelli utilizzabili su hardware di consumo.
Posso eseguire modelli 70B sul Mac mini? Praticamente no – hanno bisogno di circa 40 GB e più, e il Mac mini top fuori a 32 GB. Questo richiede un Mac Studio con memoria più unificata.
È un Mac mini o un PC di gioco con una scheda grafica migliore? Una GPU dedicata con molti VRAM è spesso più veloce sulla larghezza di banda, ma costosa e potente. Il Mac mini segna con potenza molto bassa, funzionamento tranquillo, e la capacità di caricare grandi modelli a tutti grazie alla memoria unificata.
Fonti: 9to5Materiale♪ AppleInsider♪ Apple Newsroom. Le cifre di velocità sono approssimazioni basate sulla regola di larghezza di banda del pollice e variano con modello, quantizzazione e lunghezza del contesto.

















